

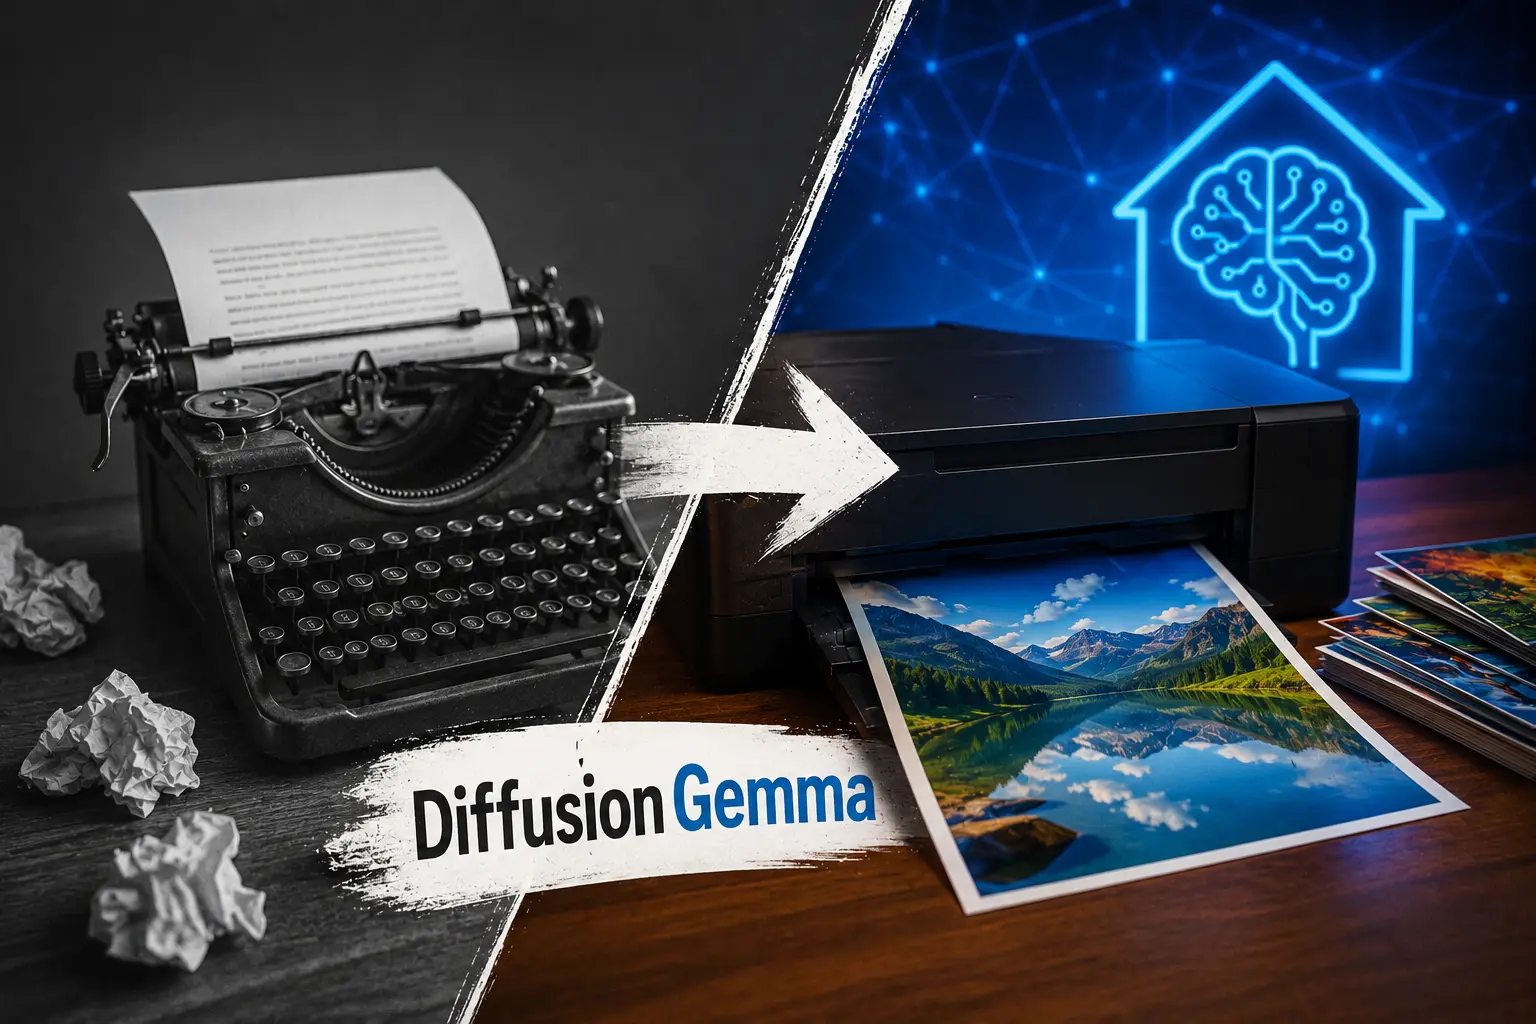
«در حالی که میدان نبرد مدلها به سمت “ممنوعیتهای دولتی” و “امنیت ملی” میرفت، گوگل یک “انقلاب زیرساختی” خاموش به راه انداخت: با الهام از دنیای تصویر، قواعد تولید متن را از “تکتک حروف” به “یکباره صفحه” تغییر داد. این یعنی “هوش مصنوعی سریع” حالا دیگر فقط برای ابر نیست؛ برای لپتاپ شماست.»
مقدمه: وقتی «نویز تصادفی» به «متن هوشمند» تبدیل میشود
در تاریخ ۱۰ ژوئن ۲۰۲۶، گوگل از مدل آزمایشی منبعباز DiffusionGemma رونمایی کرد. اما این مدل، برخلاف تمام مدلهای زبانی بزرگ متداول، یک قدم به عقب و یک جهش به جلو برداشت: به جای «تولید کلمهبهکلمه»، از تکنیک «گسترش» (Diffusion) – همان تکنیکی که برای تولید تصاویر استفاده میشود – برای تولید متن استفاده کرد.
سه بازیگر اصلی این تحول عبارتاند از: Google DeepMind که با این مدل، مرز میان «تولید تصویر» و «تولید متن» را برای همیشه محو کرده است؛ توسعهدهندگان محلی که حالا میتوانند با سختافزار معمولی، مدلی با سرعت ۱۰۰۰ توکن در ثانیه را اجرا کنند؛ و اکوسیستم منبعباز که یک مدل ۲۶ میلیارد پارامتری با مجوز Apache 2.0 دریافت کرده است. پارادوکس ماجرا این است: گوگل برای «سریعتر کردن» متن، به «آهستهترین» فرآیند در تصویر – یعنی حذف نویز گامبهگام – پناه برده است؛ و نتیجه، انقلابی در «بهرهوری سختافزار» شده است.
معماری فنی: «بومنقاشی ۲۵۶ توکنی» به جای «تایپرایتر»
برای درک DiffusionGemma، باید تفاوت بنیادین آن با مدلهای سنتی را فهمید:
- مدلهای سنتی (Autoregressive): مانند یک تایپرایتر عمل میکنند؛ کلمه به کلمه، از چپ به راست، و هر کلمه به کلمهی قبلی وابسته است. این روش در ابر کارآمد است (چون هزاران کاربر را همزمان پردازش میکند)، اما در اجرای محلی، گلوگاه «پهنای باند حافظه» (Memory Bandwidth) ایجاد میکند: GPU باید وزنهای مدل را برای هر توکن از حافظه بارگذاری کند و بخش اعظم توان پردازشی خود را بیکار نگه میدارد.
- DiffusionGemma: مانند یک «ماشین چاپ» یا «بومنقاشی» عمل میکند. به جای تولید توکنبهتوکن، یک «بوم» (Canvas) به اندازه ۲۵۶ توکن را با توکنهای تصادفی پر میکند و سپس طی چندین مرحله، این توکنهای تصادفی را همزمان به سمت متن نهایی «پالایش» (Denoise) میکند. این یعنی GPU یک بار، یک بلوک کامل ۲۵۶ توکنی را پردازش میکند و گلوگاه را از «پهنای باند حافظه» به «قدرت محاسبات» منتقل میسازد – و دقیقاً همان جایی که GPUها در آن قوی هستند.
معماری دقیق این مدل:
- پایه: بر اساس خانواده Gemma 4 با معماری Mixture-of-Experts (MoE) ۲۶ میلیارد پارامتری ساخته شده است.
- پارامترهای فعال: در هر بار استنتاج، تنها ۳.۸ میلیارد پارامتر فعال میشوند.
- پنجره متنی: ۲۵۶ توکن در هر «بوم»؛ برای متون بلندتر، از مکانیزم «بلوک خودرگرسیون گسترش» (Block Autoregressive Diffusion) استفاده میکند که بومهای ۲۵۶ توکنی را پشت سر هم پردازش میکند.
- ورودی چندوجهی: بهصورت بومی از ورودیهای متن، تصویر و ویدئو پشتیبانی میکند.
- معماری: از یک رمزگزار خودرگرسیون (Encoder) برای پردازش پرامپت و یک رمزگشای دوطرفه (Decoder with Bidirectional Attention) برای تولید متن استفاده میکند.
- حالت تفکر (Thinking Mode): دارای کانالهای استدلال قابلپیکربندی برای حل مسائل گامبهگام است.
عملکرد: ۴ برابر سریعتر، با یکچهارم حافظه
اعداد عملکرد DiffusionGemma، مرزهای ممکن را جابهجا کرده است:
- سرعت خیرهکننده: روی یک NVIDIA H100، به بیش از ۱۰۰۰ توکن در ثانیه میرسد. روی GeForce RTX 5090، سرعت به ۷۰۰+ توکن در ثانیه میرسد. این یعنی ۴ برابر سریعتر از مدلهای خودرگرسیون همتراز در همان سختافزار. در مقام مقایسه، Gemma 4 26B A4B با MTP تنها به ۳۰۰+ توکن در ثانیه میرسد.
- حافظه کممصرف: با وجود ۲۶ میلیارد پارامتر، به لطف معماری MoE و کوانتیزاسیون، تنها ۱۸ گیگابایت VRAM اشغال میکند – یعنی روی یک RTX 4090 بهراحتی اجرا میشود.
- توانایی خوداصلاحی: مدل میتواند در حین تولید، کل بلوک ۲۵۶ توکنی را همزمان ارزیابی کرده و اشتباهات را اصلاح کند. این برخلاف مدلهای سنتی است که پس از تولید یک توکن، راه برگشتی ندارند.
- عملکرد در بنچمارکها: در LiveCodeBench امتیاز ۳۰.۹٪، در BigCodeBench امتیاز ۴۵.۴٪ و در HumanEval امتیاز ۸۹.۶٪ کسب کرده است. در AIME 2025 نیز امتیاز ۲۳.۳٪ را ثبت کرده است.
قمار استراتژیک گوگل: «سرعت» در برابر «کیفیت»
گوگل با DiffusionGemma، یک قمار عمدی انجام داده است. این مدل بهصراحت یک «مدل آزمایشی» (Experimental) معرفی شده است و گوگل تأکید کرده که کیفیت خروجی آن از Gemma 4 استاندارد پایینتر است.
این قمار در چه نقطهای تعریف میشود؟
- مخاطب هدف: محققان و توسعهدهندگانی که به دنبال سرعت در تعاملات محلی هستند، نه حداکثر کیفیت برای تولید محتوای نهایی.
- موارد استفاده ایدهآل: ویرایش درونخطی (In-line Editing)، تکمیل کد (Code Completion)، تولید ساختارهای غیرخطی مانند دنبالههای اسید آمینه یا گرافهای ریاضی.
- محدودیتها: در بارهای کاری با QPS بالا (درخواست در ثانیه) در ابر، مزیت سرعت آن کاهش مییابد و مدلهای خودرگرسیون همچنان کارآمدتر هستند.
به عبارت دیگر، گوگل با DiffusionGemma، یک «مسیر موازی» برای هوش مصنوعی گشوده است: یک مسیر برای «کیفیت» (Gemma 4) و یک مسیر برای «سرعت» (DiffusionGemma). و این دقیقاً همان چیزی است که اکوسیستم منبعباز به آن نیاز داشت: آزادی انتخاب بین «بهترین» و «سریعترین».
جدول مقایسه: DiffusionGemma در برابر Gemma 4
| ویژگی | DiffusionGemma | Gemma 4 (استاندارد) |
|---|---|---|
| روش تولید | گسترش (Diffusion) – همزمان و بلوکی | خودرگرسیون (Autoregressive) – توکنبهتوکن |
| معماری | ۲۶B MoE (۳.۸B فعال) | ۲۶B MoE (۴B فعال) |
| سرعت (H100) | ۱۰۰۰+ توکن/ثانیه | ~۳۰۰+ توکن/ثانیه (با MTP) |
| حافظه موردنیاز | ~۱۸GB VRAM | ~۱۸GB VRAM |
| کیفیت خروجی | پایینتر از Gemma 4 | استاندارد طلایی |
| موارد استفاده | تعاملات محلی، ویرایش لحظهای، کدنویسی | تولید محتوای باکیفیت |
| مجوز | Apache 2.0 | Apache 2.0 |
| وضعیت | آزمایشی (Experimental) | تولیدی (Production) |
«لحظهای که متن از تصویر الهام گرفت»
نام این رویداد را باید «لحظه همگرایی» گذاشت. DiffusionGemma نشان داد که مرز بین «تولید تصویر» و «تولید متن» نه فقط قابلعبور، که میتواند منبعی برای نوآوری باشد. گوگل با الهام از Stable Diffusion، یک مدل زبانی ساخته که مثل یک نقاش عمل میکند: از یک بوم خالی شروع میکند، لایهبهلایه آن را پر میکند، و در نهایت یک اثر کامل را همزمان به نمایش میگذارد.
پرسش بیپاسخ این است: آیا «کیفیت» قربانی «سرعت» خواهد شد، یا با بهبودهای آینده، DiffusionGemma به سطح Gemma 4 خواهد رسید؟ گوگل خود تأکید کرده که از طریق فاینتونینگ میتوان عملکرد آن را در وظایف خاص بهبود بخشید – و نمونهی حل Sudoku با دقت ۱۰۰٪، گواه این ادعاست.
یک چیز قطعی است: DiffusionGemma با ۱۰۰۰ توکن در ثانیه و ۱۸ گیگابایت حافظه، ثابت کرد که «هوش مصنوعی سریع» دیگر فقط برای ابر نیست؛ حالا روی لپتاپ شما نیز اجرا میشود. این مدل با معماری نوآورانهی خود، به توسعهدهندگان محلی این امکان را داده که بدون نیاز به ابر، با سرعتی بیسابقه، برنامههای تعاملی هوش مصنوعی بسازند. سؤال این نیست که آیا این رویکرد جایگزین مدلهای سنتی خواهد شد – که نخواهد شد. سؤال این است که آیا اکوسیستم منبعباز میتواند از این «دوگانگی سرعت و کیفیت» برای خلق نسل جدیدی از برنامههای محلی استفاده کند.
۱۳ پاسخ به “DiffusionGemma: پایان «تایپرایتر» و آغاز «ماشین چاپ» در عصر هوش مصنوعی محلی”
مفید و کاربردی 👌
عالی بود مرسی 🔥
بدک نبود در کل
خوب بود
تشکر
ممنون داداش
پشمام چقدر خوب بود
جالبه
مفید و کاربردی 👌
جالبه
بدک نبود در کل
خوب بود
دقیقا همینطوره