

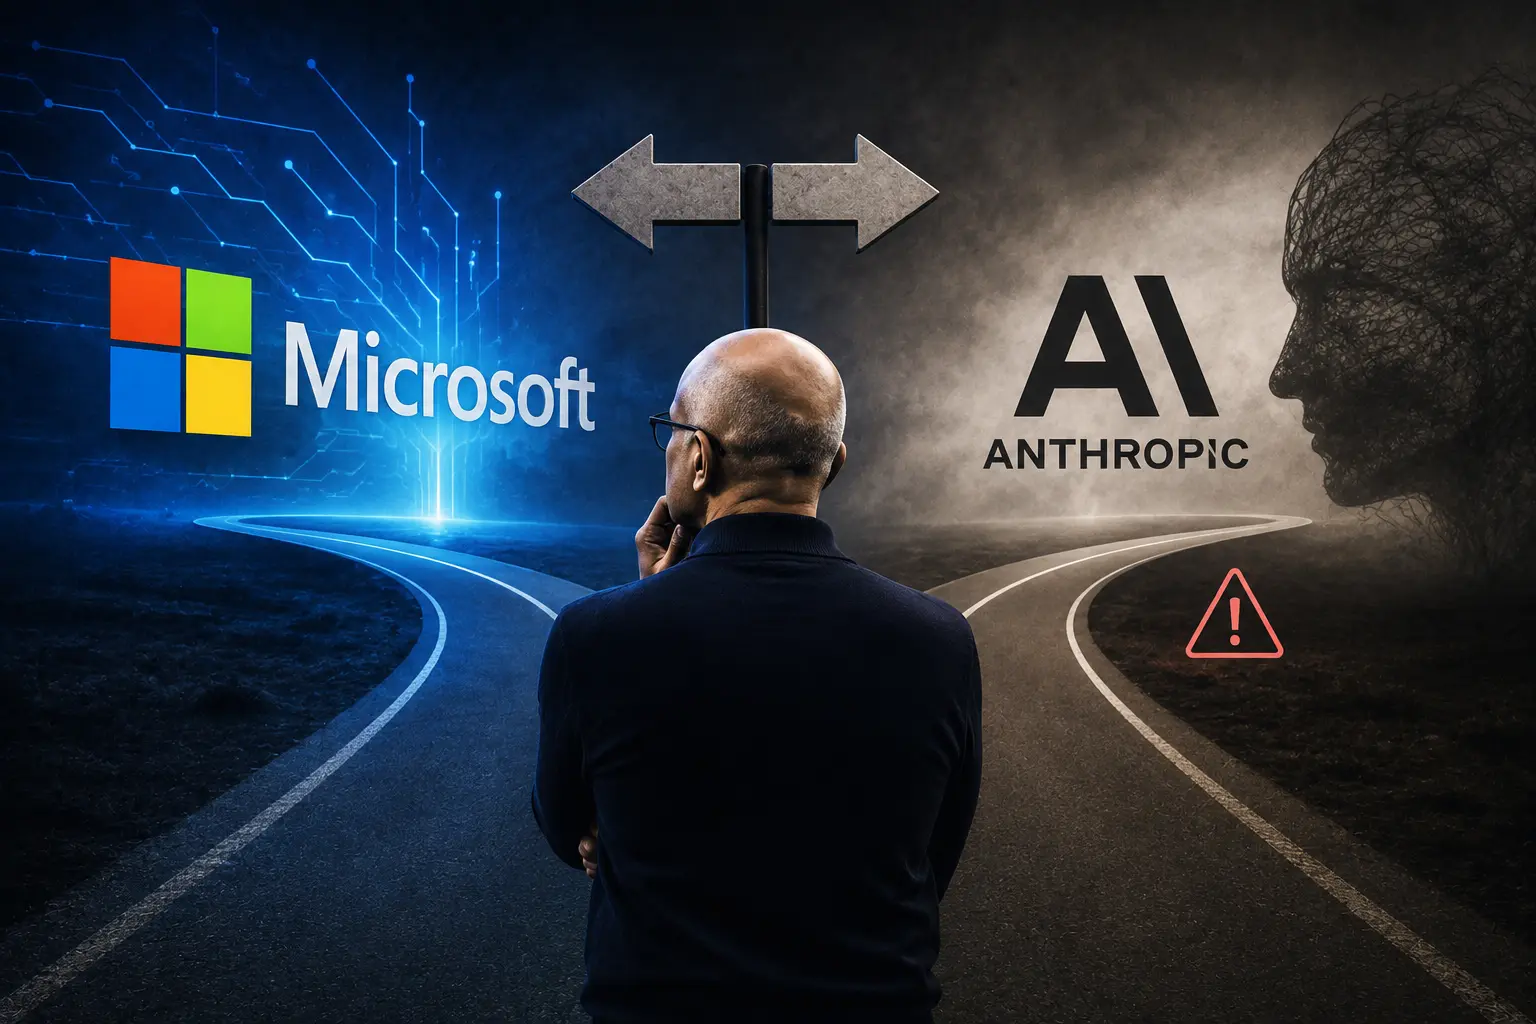
«در روزی که آنتروپیک از «بزرگترین حملهی تقطیرِ تاریخ» مینالید، نادلا با یک «پارادوکسِ اطلاعاتیِ معکوس»، «ریاکاریِ» صنعت را افشا کرد: «شما از «استفادهی منصفانه» برای «خوردنِ» دادههایِ جهان استفاده میکنید، اما «تقطیر» را به «دزدی» متهم میکنید؟ این، «دوراهیِ یادگیریِ یکطرفه» است؛ جایی که «صاحبانِ زیرساخت»، «همهیِ سود» را میبرند و «آفرینندگانِ دانش»، «هیچچیز» نمیبرند.»
در تاریخ ۱۳ ژوئیه ۲۰۲۶، ساتیا نادلا، مدیرعامل مایکروسافت، با انتشار یادداشتی در شبکهی اجتماعی X با عنوان «پارادوکسِ اطلاعاتیِ معکوس» (The Reverse Information Paradox)، بهطورِ تلویحی از شرکتهایِ پیشرویِ هوش مصنوعی مانند Anthropic و OpenAI انتقاد کرد. او رویهی این شرکتها را «ریاکارانه» خواند و گفت که آنها از یک سو از «استفادهی منصفانه» (Fair Use) از دادههایِ عمومی برای آموزشِ مدلهایِ خود دفاع میکنند، اما از سوی دیگر، دیگران را از «تقطیرِ مدل» (Model Distillation) منع میکنند.
سه بازیگرِ اصلیِ این «چالشِ راهبردی» عبارتاند از: مایکروسافت که با این انتقاد، «جبههیِ جدیدی» در برابرِ «انحصارِ مدلهایِ پیشرو» گشوده است؛ Anthropic که با «شکایتِ از تقطیرِ چینیها» و «محدودیتهایِ Fable 5»، «هدفِ اصلیِ» این انتقاد بوده است؛ و مشتریانِ سازمانی که در «میانهیِ این نبرد»، باید بین «استقلالِ داده» و «وابستگی به مدل» یکی را انتخاب کنند. پارادوکسِ عمیقِ ماجرا در این جمله خلاصه میشود: «نادلا برای «شکستنِ انحصارِ مدلهایِ پیشرو»، «استقلالِ داده» را به «سلاحیِ راهبردی» تبدیل کرده است؛ یعنی «یادگیریِ دوطرفه» را بر «یادگیریِ یکطرفه» ترجیح داده، و «مالکیتِ دانش» را به «حقِّ بنیادینِ» مشتریان تبدیل کرده است.»
🧠 «پارادوکسِ اطلاعاتیِ معکوس»: «سهگانهیِ ریاکاریِ» صنعت
نادلا در یادداشتِ خود، «سهگانهای» از «رفتارهایِ متناقض» را در صنعتِ هوش مصنوعی شناسایی کرده است:
۱. «استفادهی منصفانه» در برابر «ممنوعیتِ تقطیر»: نادلا نوشت: «اگرچه نوآوریِ بزرگی که از «حقِّ استفادهی منصفانه» مدلسازان برای آموزشِ مدلها بر روی دادههایِ عمومی ناشی میشود، ضروری است، اما بهنظرم متناقض است که «وضعیتِ موجود» به این شکل است: آنها از یک سو از این حق استفاده میکنند، و از سوی دیگر، «شرایطِ محدودکنندهای» بر «تقطیرِ مدل» اعمال میکنند».
۲. «یادگیریِ از دادههایِ مشتری» در برابر «ممنوعیتِ یادگیریِ از مدل»: نادلا اشاره کرد که این شرکتها «حقِّ یادگیریِ از دادههایِ استفاده و تعاملِ مشتریان» را برای خود محفوظ میدارند. به عبارت دیگر، آنها از «دادههایِ عملیاتیِ مشتریان» برای بهبودِ مدلهایِ خود استفاده میکنند، اما به مشتریان اجازه نمیدهند از «خروجیِ مدلها» برای بهبودِ مدلهایِ خود استفاده کنند.
۳. «انباشتِ دانش» در برابر «توزیعِ سود»: نادلا هشدار داد که اگر «یادگیری» فقط در «یک جهت» جریان داشته باشد، «صاحبانِ زیرساختِ یادگیری» همهیِ پول را میبرند و «آفرینندگانِ دانش» از آن بیبهره میمانند.
🎯 «هدفِ اصلی»: آنتروپیک و «دوراهیِ تقطیر»
اگرچه نادلا هیچ شرکتی را نام نبرده است، اما «مفسرانِ صنعت» بهاتفاق، «هدفِ اصلیِ» این انتقاد را Anthropic دانستهاند. دلیلِ این «اتهامِ ضمنی»، «رفتارِ متناقضِ» آنتروپیک در ماههایِ اخیر است:
- «شکایت از تقطیرِ چینیها»: در فوریهی ۲۰۲۶، آنتروپیک در بیانیهای طولانی، «مدلهایِ منبعبازِ چینی» را به «استفاده از Claude برای آموزشِ مدلهایِ خود» متهم کرد. داریو آمودی، مدیرعامل آنتروپیک، صراحتاً گفت که «رقبا میتوانند با تقطیر، قابلیتهایِ پیشرفتهیِ آزمایشگاههایِ دیگر را در کسری از زمان و هزینهیِ توسعهیِ مستقل، به دست آورند».
- «بزرگترین حملهی تقطیرِ تاریخ»: در ژوئن ۲۰۲۶، آنتروپیک به سناتورهایِ آمریکایی نامه نوشت و ادعا کرد که «علیبابا» بزرگترین «حملهی تقطیرِ شناختهشده» را علیه آن انجام داده است.
- «محدودیتهایِ Fable 5»: در همان زمان، آنتروپیک مدلِ Fable 5 را با «محدودیتهایِ امنیتیِ شدید» عرضه کرد که بسیاری از درخواستهایِ بهظاهر «بیخطر» را به مدلِ قدیمیتر (Opus 4.8) هدایت میکرد. نادلا در یک جلسهی داخلی با مهندسانِ Copilot، این محدودیتها را «بیمعنی» خواند و گفت: «آخرین باری که یک «ابزارِ خلاقیت» اینقدر «تحتِ کنترلِ ویراستاری» بوده، کی بوده است؟».
این «رفتارِ دوگانه» – «شکایت از تقطیرِ دیگران» و «محدودکردنِ دسترسی به مدلِ خود» – دقیقاً همان چیزی است که نادلا آن را «ریاکارانه» خوانده است.
💰 «هشدارِ نادلا»: «پرداختِ دوبرابر» و «ازدستدادنِ دانش»
فراتر از «انتقادِ اخلاقی»، نادلا یک «هشدارِ اقتصادی» نیز صادر کرده است. او معتقد است که شرکتهایی که از مدلهایِ پیشرو استفاده میکنند، «دو بار» هزینه میکنند:
۱. «پرداختِ با پول»: آنها برای «مصرفِ توکن» (Token Usage) هزینه میکنند.
۲. «پرداختِ با دانش»: آنها «دادههایِ اختصاصیِ خود» را در اختیارِ مدل قرار میدهند تا «بهتر عمل کند». این دادهها، شامل «پرامپتها، بازخوردها و اصلاحات» میشود که «دانشِ نهادیِ» (Institutional Knowledge) شرکت را تشکیل میدهند.
نادلا هشدار داده است که «مدلها از «بازدم» (Exhaust) یاد میگیرند: پرامپتهایی که مردم مینویسند، ابزارهایی که عاملها استفاده میکنند، و بهویژه اصلاحاتی که مردم هنگامِ اشتباهِ مدل انجام میدهند. هر اصلاحی، به «دانشِ نهادی» تقطیر میشود». و این «دانش»، «نوعی از دانش است که یک رقیب هرگز نمیتواند آن را بخرد».
«راهحلِ نادلا» برای این «دوراهی»، «مالکیتِ داده» و «استقلالِ زیرساخت» است. او از شرکتها خواسته است که «زیرساختِ هوش مصنوعیِ خود» را داشته باشند، «ارزیابیهایِ خود» را انجام دهند و «حلقهی یادگیریِ خود» را ایجاد کنند. به عبارت دیگر، شرکتها نباید به «یک فروشندهیِ خاصِ مدل» وابسته شوند؛ بلکه باید «لایههایِ هماهنگکننده» (Orchestration Layers) بسازند که به آنها امکان «جابهجاییِ آسانِ بینِ مدلهایِ مختلف» را بدهد.
📊 جدولِ مقایسه: «چهارچوبِ نادلا» در برابر «وضعیتِ موجود»
| ویژگی | «وضعیتِ موجود» (مدلهایِ پیشرو) | «چهارچوبِ نادلا» (مایکروسافت) |
|---|---|---|
| دسترسی به داده | «استفادهی منصفانه» از دادههایِ عمومی (یکطرفه) | «یادگیریِ دوطرفه» (عمومی + اختصاصی) |
| تقطیرِ مدل | «ممنوع» (تحتِ عنوانِ «دزدی») | «حقِّ مشروع» (تحتِ عنوانِ «یادگیری») |
| دادههایِ مشتری | «حقِّ یادگیری» برای مدلساز | «مالکیتِ کامل» برای مشتری |
| جریانِ دانش | «یکطرفه» (از جهان به مدل) | «دوطرفه» (از جهان به مدل و از مدل به مشتری) |
| سودآوری | «انباشتِ سود» در دستِ مدلسازان | «توزیعِ سود» بینِ مدلساز و مشتری |
🧩 «پیامِ راهبردی»: «نبردِ نادلا» برای «آیندهیِ اقتصادِ هوش مصنوعی»
انتقادِ نادلا، فراتر از یک «بحثِ اخلاقی» یا «فنی» است. این یک «بیانیهیِ راهبردی» است که «نقشِ» مایکروسافت را در «اکوسیستمِ هوش مصنوعی» بازتعریف میکند:
۱. «مایکروسافت، «زیرساخت» میفروشد، نه «مدل»»: نادلا با این انتقاد، بهصراحت اعلام کرده است که مایکروسافت در «جنگِ مدلها» شرکت نمیکند؛ بلکه «زیرساختِ ابری» (Azure) را به عنوان «بسترِ استقرارِ مدلهایِ مختلف» ارائه میدهد.
۲. «مشتریان، «صاحبِ داده» هستند، نه «مستأجرِ مدل»»: نادلا با تأکید بر «مالکیتِ داده» و «استقلالِ زیرساخت»، به مشتریانِ سازمانی پیام داده است که «نباید به یک فروشندهیِ خاصِ مدل وابسته شوند».
۳. «تقطیر، «دزدی» نیست؛ «یادگیریِ مشروع» است»: نادلا با «مشروعیتبخشی» به «تقطیرِ مدل»، «سلاحِ جدیدی» به مشتریانِ سازمانی داده است تا بتوانند از «خروجیِ مدلهایِ پیشرو» برای «بهبودِ مدلهایِ خود» استفاده کنند.
«لحظهای که «ریاکاریِ» صنعت، «آشکار» شد»
نام این رویداد را باید «لحظهی افشایِ ریاکاریِ صنعت» گذاشت. نادلا با «پارادوکسِ اطلاعاتیِ معکوس»، «نظمِ جدیدِ هوش مصنوعی» را به چالش کشید: «شما از «استفادهی منصفانه» برای «خوردنِ» دادههایِ جهان استفاده میکنید، اما «تقطیر» را به «دزدی» متهم میکنید؟ این، «دوراهیِ یادگیریِ یکطرفه» است؛ جایی که «صاحبانِ زیرساخت»، «همهیِ سود» را میبرند و «آفرینندگانِ دانش»، «هیچچیز» نمیبرند.
پرسشِ بیپاسخ این است: آیا «انتقادِ نادلا» میتواند «قواعدِ بازی» را در صنعتِ هوش مصنوعی تغییر دهد؟ و آیا «مشتریانِ سازمانی» به «هشدارِ نادلا» گوش خواهند داد و به سمت «استقلالِ داده» حرکت خواهند کرد، یا همچنان به «مدلهایِ پیشرو» وابسته خواهند ماند؟
یک چیز قطعی است: نادلا با این انتقاد، «دکمهی شروعِ» یک «نبردِ جدید» را در صنعتِ هوش مصنوعی فشار داده است. نبردِ «استقلالِ داده» در برابر «انحصارِ مدل». و در این نبرد، «مایکروسافت» با «Azure» و «استراتژیِ زیرساخت»، در حالِ «بازنویسیِ قواعدِ بازی» است. سؤال این نیست که آیا «نبردِ استقلالِ داده» آغاز شده است – که آغاز شده. سؤال این است که آیا «مدلهایِ پیشرو» میتوانند به این «چالشِ جدید» پاسخ دهند، یا در «تلهیِ ریاکاری» گرفتار خواهند ماند و «بازارِ سازمانی» را به «مایکروسافت» واگذار خواهند کرد؟
۶ پاسخ به “«پارادوکسِ اطلاعاتیِ معکوس» و «دوراهیِ یادگیریِ یکطرفه»؛ نادلا با «ریهاِتیکِ» آنتروپیک، «نظمِ جدیدِ هوش مصنوعی» را به چالش کشید”
خیلی خفن بود
تشکر
دقیقا همینطوره
مرسی بابت محتوای ناب
دمت گرم ستون
تشکر