

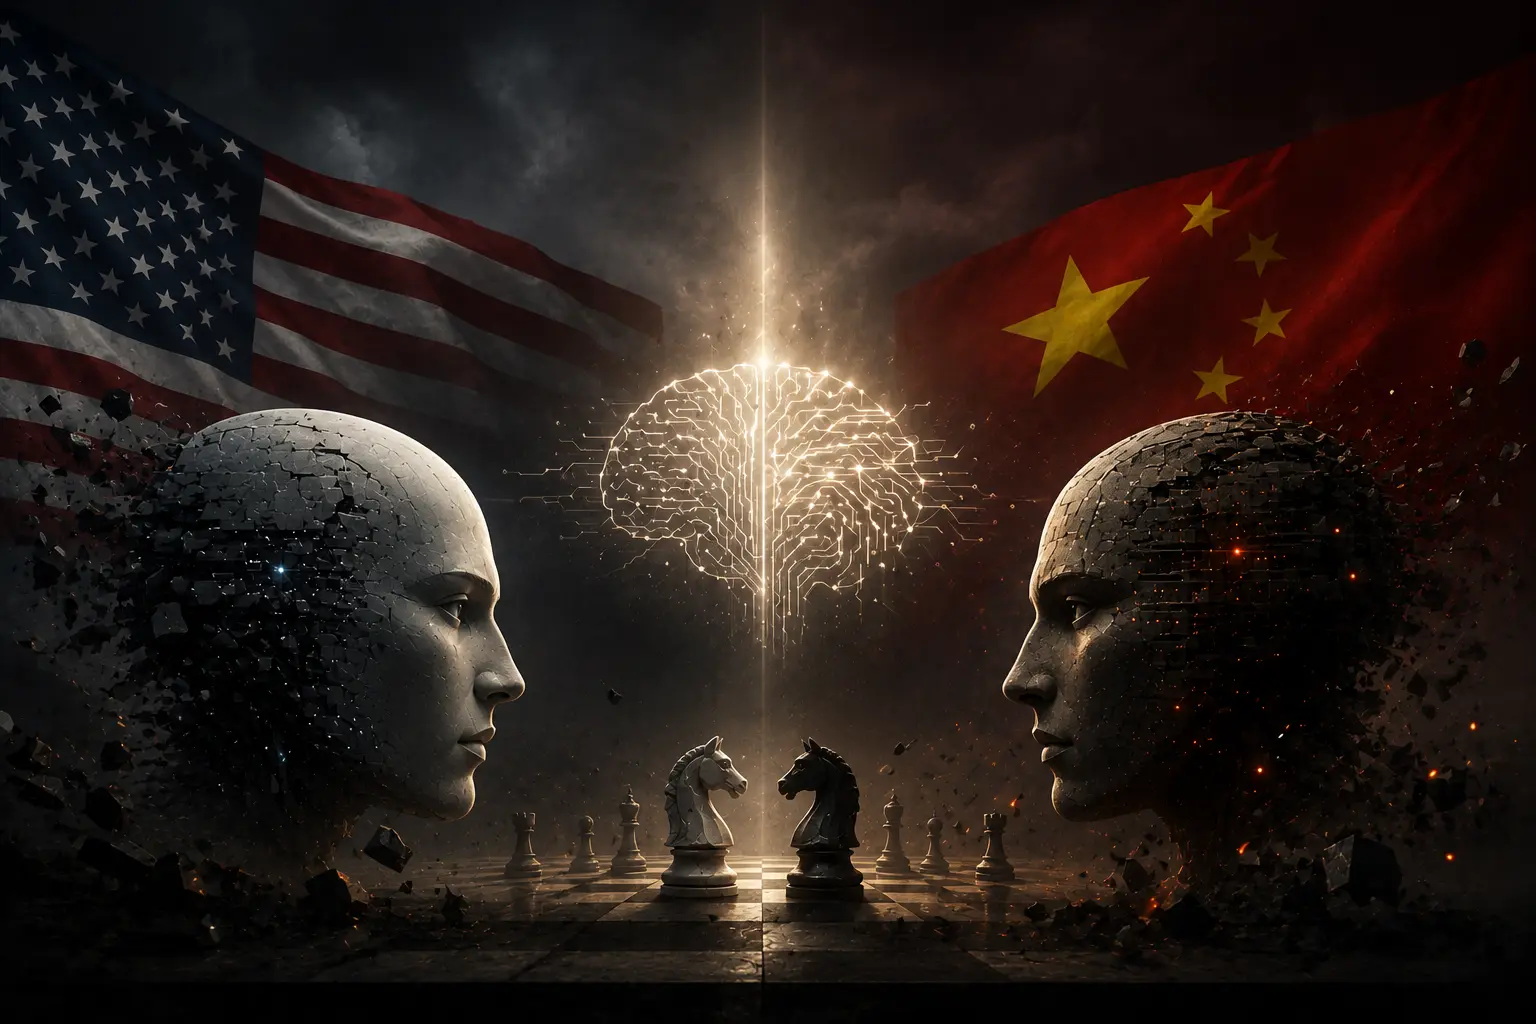
چشمانداز رقابت هوش مصنوعی در سال ۲۰۲۶ وارد مرحلهای پارادوکسیکال شده است: از یک سو، شکاف عملکردی میان مدلهای پیشرو آمریکا و چین به کمینهٔ تاریخی خود رسیده، و از سوی دیگر، شکاف راهبردی در لایههای زیرساخت، رویکردهای توسعه و مدلهای اقتصادی عمیقتر از همیشه شده است. گزارش ۴۲۳ صفحهای «شاخص هوش مصنوعی ۲۰۲۶» دانشگاه استنفورد، فاصلهٔ عملکردی میان مدلهای دو کشور را «عملاً بسته شده» توصیف میکند: تا مارس ۲۰۲۶، مدل Claude Opus 4.6 با امتیاز Elo برابر با ۱۵۰۳ در صدر قرار دارد و بهترین مدل چینی با اختلاف تنها ۲.۷٪ در تعقیب آن است. اما در زیر این سطح از همگرایی، یک «بازی نامتقارن» در جریان است که در آن هر یک از دو قدرت، با ابزارها و استراتژیهای fundamentally different به میدان آمدهاند.
این گزارش به تحلیل لایهلایهٔ این رقابت چندبعدی میپردازد: از معماریهای مدلسازی و کارایی محاسباتی تا زنجیرهٔ تأمین تراشه، استراتژیهای متنباز در برابر مالکیتی، پویاییهای سرمایهٔ انسانی، و چشمانداز ۲۰۳۰ برای دستیابی به هوش فوقجامع.
۱. همگرایی در عملکرد، واگرایی در فلسفه: ظهور «لحظهٔ دوم دیپسیک»
۲۴ آوریل ۲۰۲۶ به عنوان یک نقطهٔ عطف در تاریخ رقابت هوش مصنوعی ثبت شد. در یک «جمعهٔ دیوانهوار» برای توسعهدهندگان جهانی، OpenAI مدل GPT-5.5 را با وعدهٔ «هوش فوقالعاده» عرضه کرد و تنها ۱۲ ساعت بعد، دیپسیک (DeepSeek) نسخهٔ پیشنمایش V4 خود را به صورت متنباز منتشر نمود. این همزمانی، گویای شکافی است که اکنون صنعت هوش مصنوعی را تعریف میکند: رقابت صرفاً بر سر عملکرد نیست، بلکه بر سر مدلهای اقتصادی، دسترسیپذیری و حاکمیت فناورانه است.
دیپسیک V4 در دو پیکربندی عرضه شد: V4 Pro با ۱.۶ تریلیون پارامتر کل (۴۹ میلیارد پارامتر فعال در هر توکن) که برای کدنویسی و وظایف عاملیتی پیچیده بهینه شده، و V4 Flash با ۲۸۴ میلیارد پارامتر کل (۱۳ میلیارد فعال) برای استنتاج سریعتر و کمهزینهتر. V4 Pro در بنچمارک GDPval-AA که سنجهای برای وظایف عاملیتی دنیای واقعی است، با امتیاز ۱۵۵۴ در صدر تمامی مدلهای متنباز قرار گرفت و از رقبایی چون Kimi K2.6 (۱۴۸۴) و GLM-5.1 (۱۵۳۵) پیشی گرفت. در سنجههای ریاضی، V4 به دقت ۹۲.۶٪ در GSM8K و ۹۹.۴٪ در AIME 2026 دست یافت که آن را در سطح مدلهای پیشرو بسته قرار میدهد.
اما برگ برندهٔ واقعی، نه عملکرد مطلق، که کارایی اقتصادی است. پردازش همان حجم کاری با V4 Pro حدود ۵.۲۲ دلار هزینه دارد، در حالی که همین کار با GPT-5.5 معادل ۳۵ دلار هزینه در بر خواهد داشت — یعنی تقریباً یکششم قیمت، با حفظ ۹۰.۱٪ از عملکرد در سنجشهای استدلال پیشرفته. قیمت API دیپسیک V4 Pro معادل ۱.۷۴ دلار به ازای هر میلیون توکن ورودی است، در برابر ۵ دلار برای GPT-5.5. این اختلاف فاحش، عملاً مدل قیمتگذاری پریمیوم OpenAI را تحت فشار قرار داده است.
از نظر معماری، نوآوری کلیدی V4 در «مکانیسم توجه هیبریدی» (Hybrid Attention) نهفته است که حافظهٔ کش را تا ۱۰٪ مدلهای نسل قبل کاهش میدهد و پنجرهٔ زمینهای ۱ میلیون توکنی را بدون گلوگاه حافظه ممکن میسازد. این پیشرفت، شش ماه پس از «لحظهٔ دیپسیک» نخستین — زمانی که R1 در ژانویه ۲۰۲۵ با منابع محدود، مدلهای آمریکایی را به چالش کشید — نشان داد که استراتژی «کارایی افراطی» (Extreme Efficiency) چین، به بلوغ رسیده است.
۲. محور تراشه: از CUDA تا CANN، از تحریم تا خودکفایی
در لایهٔ سختافزار، رقابت آمریکا و چین وارد یکی از سرنوشتسازترین مراحل خود شده است. دولت آمریکا با گسترش دامنهٔ کنترلهای صادراتی به معماری Blackwell و وضع تعرفهٔ ۲۵٪ بر واردات نیمههادیهای پیشرفته، حلقهٔ محاصره را تنگتر کرده است. جنسن هوانگ، مدیرعامل انویدیا، در کنفرانس مؤسسه میلکن در ۵ مه ۲۰۲۶ صراحتاً اعلام کرد که «بلکول و روبین به چین فروخته نخواهند شد» و تأیید کرد که سهم بازار انویدیا از شتابدهندههای هوش مصنوعی در چین «عملاً به صفر» رسیده است.
اما این خلأ، به شکلی پارادوکسیکال، به کاتالیزوری برای تسریع خودکفایی چین تبدیل شده است. همزمان با انتشار DeepSeek V4، این شرکت اعلام کرد که مدل جدید را بهطور کامل با تراشههای Huawei Ascend 950PR سازگار کرده است — نخستین باری که یک مدل زبانی بزرگ پیشرفته، کل پشتهٔ آموزش تا استنتاج را روی سختافزار کاملاً بومی چین اجرا میکند. این اقدام، نه صرفاً یک دستاورد فنی، بلکه یک «اعلام استقلال» از زیستبوم CUDA انویدیاست.
تراشهٔ Ascend 950PR که در مارس ۲۰۲۶ وارد تولید انبوه شد، با پشتیبانی از دقت FP4 (با توان ۱.۵۶ PFLOPS)، حافظهٔ HBM کاملاً خودتوسعهیافته، و کارایی ۲.۸۷ برابری نسبت به H20 انویدیا، نشاندهندهٔ بلوغ رویکرد «رقابت در سطح سیستم» هوآوی است. نقشهٔ راه هوآوی، iterative و بلندپروازانه است: Ascend 960 برای ۲۰۲۷ با ابرگرههای ۱۵,۴۸۸ تراشهای، و Ascend 970 برای ۲۰۲۸ با جهش معماری بعدی. هوآوی با خودتوسعهدهی حافظهٔ HBM، انحصار دوگانهٔ SK Hynix و Samsung را شکسته و گلوگاه ذخیرهسازی را برای استقرارهای عظیم از میان برداشته است.
استراتژی هوآوی بر «مقیاسافزایی افقی افراطی» (Extreme Horizontal Scaling) استوار است: به جای رقابت در عملکرد تکتراشه، از ابرگرههای ۵۰ تا ۱۰۰ هزار تراشهای استفاده میکند که با اتصالات داخلی پرسرعت و خنککنندهٔ مایع با چگالی بالا مدیریت میشوند. پیامد راهبردی این رویکرد، ایجاد یک «مسیر جایگزین» برای کل صنعت هوش مصنوعی جهانی است: اگر مسیر CUDA پیشتر تنها گزینه بود، اکنون CANN (Compute Architecture for Neural Networks) هوآوی یک آلترناتیو واقعی ارائه میدهد.
۳. استراتژی متنباز در برابر مالکیتی: نبرد برای اکوسیستم توسعهدهندگان
شاید عمیقترین تفاوت راهبردی میان دو کشور، در رویکرد به مدلهای متنباز و مالکیتی نمایان شود. چین به رهبری DeepSeek و Alibaba Qwen، استراتژی «متنباز در هسته» را برگزیده است. گزارش استنفورد نشان میدهد که Alibaba تا آوریل ۲۰۲۶ بیش از ۴۰۰ مدل متنباز Qwen عرضه کرده که بیش از ۲۰۰,۰۰۰ مدل مشتق (Derivative Models) و بیش از ۱ میلیارد دانلود جهانی ایجاد کرده است — بزرگترین خانوادهٔ مدلهای متنباز جهان.
این استراتژی، نقطهٔ مقابل رویکرد «مدل مرزی بسته» (Closed Frontier Model) آمریکاست که در آن OpenAI، Anthropic و Google قدرتمندترین مدلهای خود را پشت APIهای پریمیوم نگه میدارند. پیامد این واگرایی، از پیش در آمار مصرف نمایان شده است: در فوریه ۲۰۲۶، حجم فراخوانی هفتگی مدلهای چینی در پلتفرم OpenRouter برای نخستین بار از مدلهای آمریکایی پیشی گرفت و ۴ مدل از ۵ مدل برتر جهان از نظر حجم مصرف، چینی بودند — رقمی که عمدتاً توسط توسعهدهندگان خارج از چین (تنها ۶.۰۱٪ کاربران این پلتفرم چینی هستند) هدایت میشود.
طرح پنجسالهٔ چین (۲۰۲۶-۲۰۳۰) که در مارس ۲۰۲۶ رونمایی شد، هدف «ادغام هوش مصنوعی در ۹۰٪ اقتصاد کشور» را تعیین کرده و صراحتاً بر توقف وابستگی به تراشههای آمریکایی تأکید دارد. این سند، استراتژی متنباز را بهعنوان ابزاری برای «گسترش اکوسیستم نرمافزاری و ایجاد وفاداری توسعهدهندگان جهانی» توصیف میکند.
۴. سرمایهٔ انسانی: تغییر جریان مهاجرت نخبگان
یکی از یافتههای کلیدی گزارش ۲۰۲۶ استنفورد، که کمتر مورد توجه قرار گرفته اما پیامدهای بلندمدت عظیمی دارد، تغییر جریان مهاجرت نخبگان هوش مصنوعی است. این گزارش نشان میدهد که از سال ۲۰۱۷، تعداد محققان هوش مصنوعی که به آمریکا مهاجرت میکنند، ۸۹٪ کاهش یافته و تنها در یک سال گذشته ۸۰٪ افت داشته است.
در مقابل، چین با اتکا به جمعیت عظیم ۵ میلیون نفری شاغل در صنعت فناوری اطلاعات (در برابر ۲.۸ میلیون نفر در آمریکا) و فارغالتحصیلی سالانهٔ حدود ۱.۶ میلیون دانشجو در رشتههای علوم و مهندسی (۴۰٪ از کل فارغالتحصیلان دانشگاهی) از یک مزیت ساختاری در تربیت نیروی کار بهره میبرد. این در حالی است که در آمریکا، تنها ۸٪ از دانشجویان در رشتههای مهندسی و علوم کامپیوتر تحصیل میکنند.
این تغییر پارادایم — از «فرار مغزها» به «گردش مغزها» یا حتی «بازگشت مغزها» — میتواند در بلندمدت، مزیت تاریخی آمریکا در جذب بهترین استعدادهای جهانی را تضعیف کند و چین را به قطب جدیدی برای نوآوری در هوش مصنوعی تبدیل نماید.
۵. سرمایهگذاری و زیرساخت: عدم تقارن در مقیاس و کارایی
در لایهٔ مالی، آمریکا همچنان dominant است: دولت فدرال آمریکا در سال ۲۰۲۵ معادل ۴۷۱ میلیارد دلار برای توسعهٔ هوش مصنوعی هزینه کرد، در حالی که چین ۱۱۹ میلیارد دلار سرمایهگذاری نمود. شش غول فناوری آمریکا — مایکروسافت، متا، اوراکل و سایرین — متعهد به سرمایهگذاری ۶۶۰۰ تا ۷۰۰۰ میلیارد دلاری در سال ۲۰۲۶ شدهاند که تقریباً سهچهارم آن به زیرساخت هوش مصنوعی اختصاص دارد. آمریکا با ۵,۴۲۷ مرکز داده، بیش از ۱۰ برابر کل کشورهای دیگر ظرفیت دارد.
اما این برتری عددی، با دو پارادوکس همراه است: نخست، گزارش استنفورد اذعان میکند که ۹۵٪ از سرمایهگذاریهای سازمانی در هوش مصنوعی، بازدهی صفر داشتهاند. دوم، هزینهٔ آموزش مدلهای آمریکایی بهطرز فاحشی بالاتر از نمونههای چینی است: آموزش Grok 4 تخمیناً ۷۲,۸۱۶ تن CO₂ منتشر کرده، در حالی که آموزش DeepSeek-V3 تنها ۵۹۷ تن CO₂ تولید کرده است — اختلافی ۱۲۰ برابری. این شکاف کارایی، پرسشهای جدی دربارهٔ پایداری بلندمدت مدل «سرمایهگذاری عظیم، مصرف انرژی عظیم» مطرح میکند.
۶. چشمانداز ۲۰۳۰: دو مسیر به سوی هوش فوقجامع
در افق ۲۰۳۰، دو کشور دو مسیر fundamentally different به سوی ASI ترسیم کردهاند. آمریکا با تکیه بر مزیت در نوآوری بنیادین، زیرساخت عظیم محاسباتی، و کنترل زنجیرهٔ تأمین تراشههای پیشرفته (از جمله انحصار انویدیا و محدودیتهای صادراتی)، به دنبال حفظ رهبری از طریق «جهشهای کیفی» است. پروژههایی مانند Stargate (ابرمرکز ۵ گیگاواتی OpenAI) و راکتورهای هستهای ماژولار کوچک (SMRs) که مایکروسافت و گوگل در آن سرمایهگذاری کردهاند، بخشی از این استراتژی هستند.
چین اما مسیر «نفوذ تدریجی از طریق کارایی و مقیاس» را برگزیده است. اندیشکدهٔ «مؤسسه مالی چونگیانگ» دانشگاه رنمین چین، در گزارشی جامع پیشبینی کرده است که تا ۲۰۳۰، چین در هوش مصنوعی از آمریکا پیشی خواهد گرفت و «انقلاب صنعتی چهارم» را رهبری خواهد کرد. این پیشبینی بر سه ستون استوار است: (۱) کارایی هزینه — انجام بیشتر با منابع کمتر، (۲) استراتژی متنباز — تسخیر اکوسیستم توسعهدهندگان جهانی، و (۳) یکپارچگی عمودی با صنعت — ادغام هوش مصنوعی در ۹۰٪ اقتصاد تا ۲۰۳۰.
جدول مقایسهٔ راهبردی آمریکا و چین در هوش مصنوعی (۲۰۲۶)
| شاخص | آمریکا | چین |
|---|---|---|
| بهترین مدل (Elo) | Claude Opus 4.6: ۱۵۰۳ | اختلاف ۲.۷٪ |
| تعداد مراکز داده | ۵,۴۲۷ (۱۰ برابر سایر کشورها) | در حال توسعهٔ سریع |
| هزینهٔ دولت در AI (۲۰۲۵) | ۴۷۱ میلیارد دلار | ۱۱۹ میلیارد دلار |
| رویکرد مدلها | عمدتاً بسته (Closed-source) | عمدتاً باز (Open-source) |
| تراشهٔ غالب | NVIDIA H200/B200/Blackwell | Huawei Ascend 950PR/950DT |
| سهم بازار NVIDIA | ~۱۰۰٪ در آمریکا | ~۰٪ (در حال حذف) |
| کاهش مهاجرت نخبگان | -۸۹٪ از ۲۰۱۷ | – |
| هدف ۲۰۳۰ | رهبری از طریق نوآوری بنیادین | پیشی گرفتن از آمریکا |
| استراتژی غالب | جهش کیفی + انحصار سختافزاری | کارایی + نفوذ تدریجی + متنباز |
۷. نتیجهگیری: بازی پایانی یا آغاز فصلی تازه؟
رقابت آمریکا و چین در هوش مصنوعی تا سال ۲۰۲۶ به مرحلهای رسیده که میتوان آن را «همگرایی عملکردی، واگرایی راهبردی» نامید. شکاف ۲.۷٪ در عملکرد مدلها، عملاً بیمعنی بودن مسابقهٔ صرف بر سر بنچمارکها را نشان میدهد. آنچه اکنون تعیینکننده است، توانایی در تبدیل قابلیتهای الگوریتمی به مزیت اقتصادی، صنعتی و ژئوپلیتیک است.
از یک سو، آمریکا با کنترل زنجیرهٔ تأمین تراشه، مزیت در نوآوری بنیادین، و سرمایهگذاریهای عظیم، همچنان رهبر بلامنازع در لبهٔ پیشروی فناوری است. از سوی دیگر، چین با استراتژی «کارایی + متنباز + خودکفایی»، در حال ایجاد یک اکوسیستم موازی است که میتواند از وابستگی به زیرساخت آمریکایی رها شود و مدل اقتصادی پایدارتری برای عصر استنتاج انبوه ارائه دهد.
در چشمانداز ۲۰۳۰، دو سناریو محتمل است: یا دو زیستبوم موازی هوش مصنوعی — یکی مبتنی بر CUDA و مدلهای بسته، دیگری مبتنی بر CANN و مدلهای باز — شکل خواهد گرفت که جهان را به دو حوزهٔ نفوذ فناورانه تقسیم میکند، یا فشارهای اقتصادی و محدودیتهای انرژی، هر دو طرف را به سمت همگرایی بیشتر در مدلهای کسبوکار و استانداردهای فنی سوق خواهد داد. آنچه مسلم است، این است که عصر «تکقطبی» در هوش مصنوعی به سر آمده، و «دوقطبی نامتقارن» جایگزین آن شده است — نظمی که در آن، رقابت نه بر سر «چه کسی باهوشترین مدل را میسازد»، بلکه بر سر «چه کسی هوش مصنوعی را به موتور محرکهٔ اقتصاد و جامعه تبدیل میکند»، تعیینکننده خواهد بود.
ه
۱۶ پاسخ به “نبرد نهایی در قلمرو شناخت: رقابت فشردهٔ آمریکا و چین در عصر همگرایی مدلهای هوش مصنوعی”
دقیقا همینطوره
ممنون داداش
مرسی بابت محتوای ناب
دمت گرم ستون
ممنون داداش
خوب بود
عالی بود مرسی 🔥
مفید و کاربردی 👌
مرسی بابت محتوای ناب
مرسی بابت محتوای ناب
عالی بود مرسی 🔥
پشمام چقدر خوب بود
مرسی بابت محتوای ناب
بدک نبود در کل
مفید و کاربردی 👌
دمت گرم ستون